Java에서 웹 스크래핑을 하려면 HTML 파싱 라이브러리 선택이 첫 관문입니다. jsoup은 2009년부터 개발되어 온 오픈소스 Java HTML 파서로, WHATWG HTML5 명세를 구현해 최신 브라우저와 동일한 DOM 트리를 만들어냅니다. URL에서 바로 HTML을 가져와 파싱하고, CSS 선택자로 원하는 데이터를 추출하는 과정을 하나의 API로 처리할 수 있습니다. MIT 라이선스로 배포되어 상업적 프로젝트에도 부담 없이 쓸 수 있고, 런타임 의존성이 전혀 없다는 점도 실무에서 자주 언급되는 장점입니다.
jsoup이 처리하는 크롤링과 파싱의 경계
웹 데이터 추출은 보통 크롤링과 스크래핑을 나눠서 설명하지만, jsoup을 쓰면 이 구분이 흐려집니다. Jsoup.connect("https://en.wikipedia.org/").get() 한 줄에 HTTP 요청 전송과 DOM 파싱이 동시에 일어나기 때문입니다. 내부적으로 크롤링과 파싱 기능을 함께 묶은 고수준 API를 제공한다는 것이 jsoup의 설계 특징입니다.
여기서 짚고 갈 개념이 있습니다. 크롤링은 사이트에 요청을 보내 HTML을 가져오는 행위이고, 파싱은 가져온 HTML을 DOM 구조로 해석하는 작업입니다. 스크래핑은 그 DOM에서 필요한 값만 뽑아내는 단계에 해당합니다. jsoup은 이 세 단계를 자연스럽게 이어주는 도구입니다.
DOM 트리를 만드는 방식이 브라우저와 같다는 점도 중요합니다. 실제 서비스되는 HTML은 닫히지 않은 태그나 잘못 중첩된 요소가 흔한데, jsoup은 이런 비정형 마크업도 합리적인 트리로 재구성합니다. 검증된 깔끔한 HTML부터 엉망인 태그 덩어리까지 폭넓게 대응하도록 설계되어 있습니다.
시작하기 전에 확인할 robots.txt
스크래핑 코드를 작성하기 전에 대상 사이트의 robots.txt를 먼저 열어보는 것이 순서입니다. 이 파일은 크롤러에게 어떤 경로를 수집해도 되는지 알려주는 규약입니다. 예를 들어 보안뉴스의 robots.txt에는 User-agent: *와 Allow: /가 명시되어 있는데, 이는 모든 크롤러에게 사이트 전체 수집을 허용한다는 뜻입니다.
User-agent: *
Allow: /
반대로 Disallow: 항목이 특정 경로를 가리키고 있다면 그 경로는 수집 대상에서 빼야 합니다. 기술적으로 접근이 가능하더라도 규약을 무시하면 차단이나 법적 분쟁으로 이어질 수 있습니다. 요청 간격을 두는 것도 서버 부담을 줄이는 기본 예절입니다.
프로젝트에 jsoup 추가하는 방법
현재 릴리스 버전은 1.23.2입니다. 의존성 관리 도구를 쓴다면 jar 파일을 직접 내려받을 필요가 없습니다. Maven과 Gradle 설정은 각각 다음과 같습니다.
Maven을 사용하는 경우 POM의 <dependencies> 섹션에 다음을 넣습니다.
<dependency>
  <!-- jsoup HTML parser library @ https://jsoup.org/ -->
  <groupId>org.jsoup</groupId>
  <artifactId>jsoup</artifactId>
  <version>1.23.2</version>
</dependency>
Gradle을 사용하는 경우 다음 한 줄을 추가합니다.
// jsoup HTML parser library @ https://jsoup.org/
implementation 'org.jsoup:jsoup:1.23.2'
jar 파일을 직접 받는 방식도 있습니다. 이때 선택적으로 소스 jar와 javadoc jar, CLI 및 예제 jar를 함께 내려받을 수 있습니다. jsoup은 Java 8 이상에서 동작하며 Scala, Kotlin, OSGi, Lambda, Google App Engine 환경도 지원합니다.
Android 프로젝트에서 쓸 때는 주의할 점이 있습니다. jsoup의 Java 8 소스 코드를 지원하려면 NIO 명세와 함께 core library desugaring을 활성화해야 합니다.
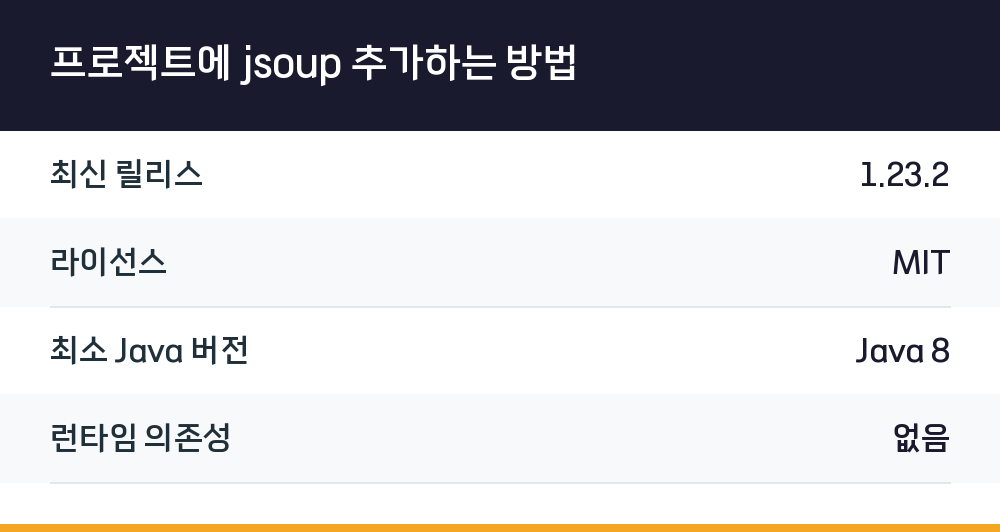
| 배포 형태 | 확인할 값 |
|---|---|
| 최신 릴리스 | 1.23.2 |
| 라이선스 | MIT |
| 최소 Java 버전 | Java 8 |
| 런타임 의존성 | 없음 |
위키백과 헤드라인을 뽑아내는 실제 코드
jsoup 공식 문서에 실린 예제를 보면 흐름이 한눈에 들어옵니다. 위키백과 홈페이지를 가져와 DOM으로 파싱한 뒤, 'In the news' 영역의 헤드라인을 Elements 리스트로 선택하는 코드입니다.
Document doc = Jsoup.connect("https://en.wikipedia.org/").get();
log(doc.title());
Elements newsHeadlines = doc.select("#mp-itn b a");
for (Element headline : newsHeadlines) {
    log("%s\n\t%s", headline.attr("title"), headline.absUrl("href"));
}
코드를 뜯어보면 단계가 분명합니다. Jsoup.connect(...).get()이 사이트에 GET 요청을 보내고 HTML을 받아옵니다. 반환된 Document 객체는 이미 파싱이 끝난 DOM 트리입니다. doc.select("#mp-itn b a")가 CSS 선택자로 원하는 요소를 골라내는 스크래핑 단계입니다. 마지막으로 반복문에서 각 요소의 title 속성과 href 절대 주소를 꺼냅니다.
absUrl("href") 메서드는 상대 경로를 절대 URL로 변환해 줍니다. 스크래핑한 링크를 그대로 저장하면 나중에 원본 페이지 기준 경로를 다시 계산해야 하는 수고를 덜어줍니다.
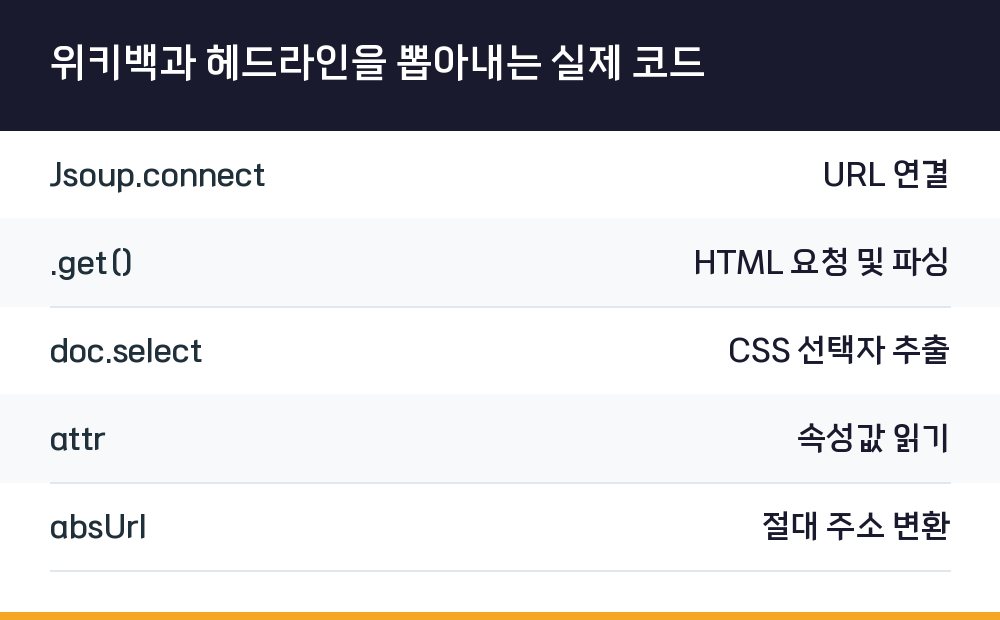
| 메서드 | 하는 일 |
|---|---|
| Jsoup.connect | URL 연결 |
| .get() | HTML 요청 및 파싱 |
| doc.select | CSS 선택자 추출 |
| attr | 속성값 읽기 |
| absUrl | 절대 주소 변환 |
선택자로 원하는 요소만 골라내기
스크래핑의 성패는 선택자를 얼마나 정확하게 쓰느냐에 달려 있습니다. jsoup은 CSS 선택자와 DOM 순회, xpath 선택자를 모두 지원합니다. 예를 들어 헤드라인 기사 목록을 가져올 때는 ul 태그 아래 li 태그를 지정하는 식으로 범위를 좁혀 나갑니다.
선택자를 잡는 순서는 다음과 같습니다.
- 브라우저 개발자 도구로 추출할 요소를 찾습니다.
- 해당 요소의 id, class, 태그 계층을 확인합니다.
- jsoup의
select()에 그 선택자를 그대로 넣어 테스트합니다. - 결과가 비어 있으면 선택자 범위를 넓혀서 어느 단계에서 끊기는지 확인합니다.
doc.title()처럼 문서 제목을 바로 꺼내는 메서드도 있고, DOM API 방식으로 부모와 자식을 거슬러 올라가며 탐색할 수도 있습니다. 구조가 자주 바뀌는 사이트라면 CSS 선택자 하나에 의존하기보다 여러 경로를 조합하는 편이 안전합니다.
수집한 HTML을 안전하게 다루는 방법
jsoup은 단순한 추출 도구를 넘어 HTML 조작과 정제 기능도 갖추고 있습니다. 요소와 속성, 텍스트를 수정할 수 있고, 사용자가 제출한 콘텐츠를 safelist 기준으로 정리해 XSS 공격을 막을 수 있습니다. 출력 단계에서는 정돈된 형태의 HTML을 만들어 줍니다.
이 기능은 스크래핑한 데이터를 다시 화면에 노출하는 서비스에서 특히 유용합니다. 외부에서 긁어온 HTML에 스크립트가 섞여 있으면 그대로 렌더링하는 순간 보안 문제가 됩니다. safelist 기반 정제를 거치면 허용된 태그와 속성만 남길 수 있습니다.
Q. jsoup은 별도 런타임 라이브러리가 필요한가요?
필요하지 않습니다. jsoup은 완전히 자체 포함되어 있어 필수 런타임 의존성이 없습니다.
Q. Android에서도 쓸 수 있나요?
사용할 수 있습니다. 다만 core library desugaring과 NIO 명세를 활성화해야 Java 8 기능이 정상 동작합니다.
Q. 잘못된 HTML도 파싱되나요?
됩니다. jsoup은 검증된 마크업부터 깨진 태그 덩어리까지 모두 합리적인 파스 트리로 재구성하도록 설계되었습니다.
Q. Maven이나 Gradle 없이 쓸 수 있나요?
가능합니다. jsoup-1.23.2.jar를 직접 내려받아 클래스패스에 추가하면 됩니다. 소스와 javadoc, 예제 jar는 선택 사항입니다.
Q. 상업적 프로젝트에 사용해도 되나요?
됩니다. jsoup은 MIT 라이선스로 배포되는 오픈소스 프로젝트이며 소스 코드는 GitHub에서 확인할 수 있습니다.